Hash Table Nedir? Collision ve Probing’i Hash Tables Lab ile Görün
Hash function, collision, separate chaining, linear ve quadratic probing, double hashing, tombstone ve rehashing süreçlerini adım adım görün.
 Harun Büyükçolak, Full Stack Developer
Yazı içeriği
Hash table, doğru koşullarda anahtarla arama, ekleme ve silme işlemlerini
ortalama O(1) zamanda yapabilen en önemli veri yapılarından
biridir. Ancak bu güçlü sonuç sihirli değildir: hash function, collision
stratejisi, load factor ve silme modeli birlikte doğru tasarlanmalıdır.
Websoftik Academy Hash Tables Lab, anahtardan final slot’a kadar bütün yolu açar. Key transformation, bucket distribution, collision, probe path, tombstone ve rehashing adımlarını aynı çalışma alanında görerek “hash table hızlıdır” cümlesinin hangi varsayımlara dayandığını öğrenirsiniz.
1. Hash Table Nedir?
Hash table, key-value çiftlerini bir array üzerinde saklayan symbol table
implementasyonudur. Hash function geniş bir key universe’ünü
0...M-1 aralığındaki bucket veya slot index’lerine dönüştürür.
index = hash(key) mod M
table[index] = value
Direct access’te key zaten küçük bir integer index ise dönüşüm gerekmez. Gerçek uygulamalarda string, büyük integer veya composite key’ler bulunduğu için hash function bu geniş alanı sınırlı table boyutuna eşler.
2. Hash Tables Lab Nasıl Çalışıyor?
Hash Tables Lab, symbol table temellerinden guided challenges’a uzanan dokuz modül içerir. Integer, float, kısa ve uzun string key’leri farklı hash yöntemleriyle dönüştürebilir; aynı input’u four collision stratejisinde lockstep olarak çalıştırabilirsiniz.
Lab yalnızca final table’ı göstermez. Her işlemde hash değeri, ilk index, incelenen slot’lar, collision ve probe sayısı, load factor, max chain veya max path gibi ölçümler güncellenir. Böylece başarılı bir insert’ün arkasında ne kadar iş yapıldığı ölçülebilir.
3. İyi Bir Hash Function Ne Yapar?
İyi bir hash function deterministik, hızlı ve key’leri table boyunca dengeli dağıtan bir fonksiyondur. Benzer key’lerin aynı bölgeye yığılması cluster’ları büyütür ve ortalama operasyon maliyetini artırır. Hash Function Studio; integer modulo, multiplication modulo, float normalization, polynomial string hashing ve Horner yöntemini adım adım karşılaştırır.
Distribution histogram; boş bucket sayısı, maksimum bucket yükü ve collision
toplamını gösterir. Aynı key set’ini farklı M değerleriyle,
özellikle prime table size ile denemek modulo pattern’lerinin dağılımı nasıl
etkilediğini görünür kılar.
4. Collision Neden Kaçınılmazdır?
Key universe table’daki slot sayısından büyükse farklı key’lerin aynı index’e gelmesi kaçınılmazdır; bu pigeonhole principle’ın doğrudan sonucudur. Collision bir hata değil, veri yapısının yönetmesi gereken normal bir olaydır.
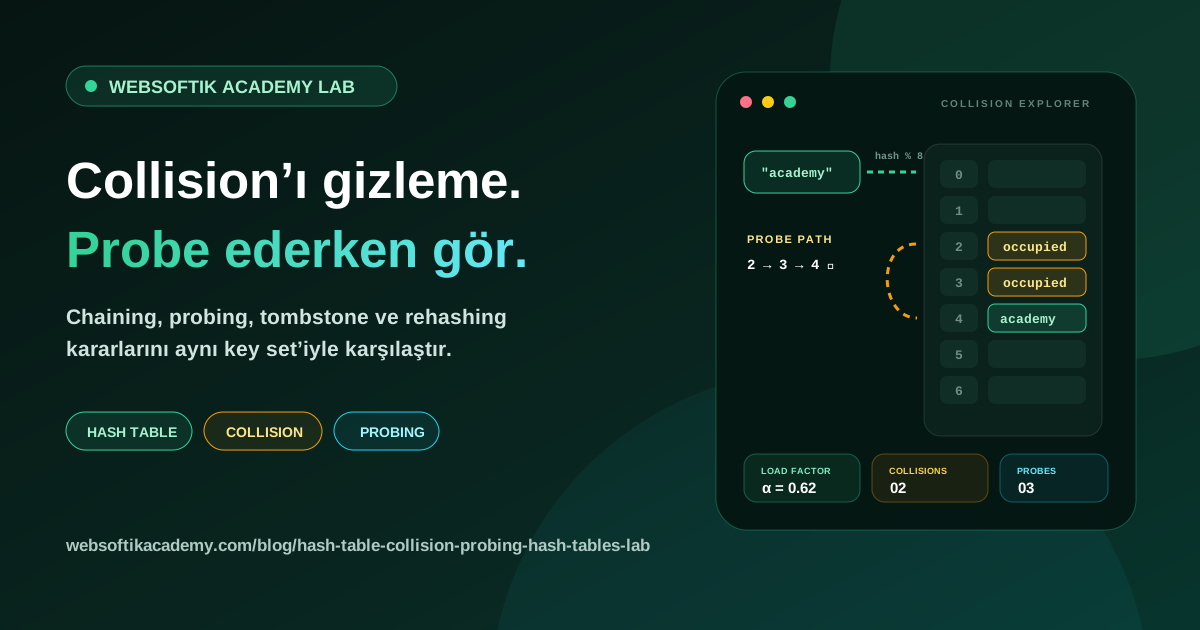
Collision Explorer aynı key dizisini separate chaining, linear probing, quadratic probing ve double hashing üzerinde birlikte yürütür. Aynı ilk collision’ın dört farklı physical layout ve arama yolu oluşturduğunu tek bakışta karşılaştırabilirsiniz.
5. Separate Chaining Nasıl Çalışır?
Separate chaining’de her bucket, o index’e hash edilen entry’lerden oluşan
bir chain tutar. Collision olduğunda yeni key aynı bucket’ın listesine
eklenir. Bu nedenle entry sayısı slot sayısından büyük olabilir ve load
factor α = n/M değeri 1’in üzerine çıkabilir.
Search önce bucket’ı bulur, sonra chain içinde key karşılaştırır. Ortalama
chain kısa kaldığı sürece operasyonlar hızlıdır; kötü dağılımda bütün key’ler
aynı bucket’a düşerek maliyeti O(n) yapabilir. Chain’in pointer
yapısını ayrıntılı görmek için
Linked List Lab rehberini kullanabilirsiniz.
6. Open Addressing Nedir?
Open addressing bütün entry’leri doğrudan table array’i içinde tutar. Hesaplanan slot doluysa belirli bir probe sequence izlenerek başka bir slot aranır. Böylece ek node ve pointer gerekmez; fakat table doldukça probe path’leri uzar ve performans hızla düşebilir.
7. Linear ve Quadratic Probing Arasındaki Fark Nedir?
Linear probing sırasıyla h(k), h(k)+1, h(k)+2... slot’larını
dener. Basit ve cache-friendly olsa da dolu slot blokları büyüyerek
primary clustering oluşturabilir. Yeni key’ler bu cluster’a
eklenme eğilimi gösterir ve problem kendini besler.
Quadratic probing offset’i karesel artırır; örneğin
h(k)+1², h(k)+2².... Primary clustering’i azaltır, fakat aynı
başlangıç index’ine sahip key’ler aynı sequence’i izlediği için secondary
clustering görülebilir. Ayrıca table size ve probe formülü bütün slot’ların
erişilebilir olup olmadığını etkiler.
8. Double Hashing Ne Kazandırır?
Double hashing ikinci bir hash function ile key’e özel step size üretir:
index_i = (h1(k) + i × h2(k)) mod M. Aynı ilk index’e düşen iki
key farklı step’ler alabildiği için probe path’leri ayrışır ve clustering
eğilimi azalır.
Step size ile M aralarında asal değilse sequence table’ın yalnızca
bir bölümünü dolaşabilir. Lab, her key’in probe yolunu çizerek matematiksel
koşulun fiziksel slot erişimine etkisini doğrudan gösterir.
9. Silmede Tombstone Neden Gerekir?
Open addressing’de silinen slot’u doğrudan EMPTY yapmak, o
slot’tan sonra yerleşmiş bir key’in search yolunu erken bitirebilir. Sonuç,
key table’da olduğu halde “bulunamadı” diyen bir false miss’tir.
Tombstone, slot’un daha önce kullanıldığını ama şu anda boş olduğunu belirtir. Search devam eder; insert ise probe kuralını bozmadan bu alanı daha sonra yeniden kullanabilir. Delete & Tombstones modülü EMPTY ile TOMBSTONE farkını aynı probe chain üzerinde canlandırır.
10. Load Factor ve Rehashing Performansı Nasıl Etkiler?
Load factor α = n/M, entry sayısının table kapasitesine oranıdır.
Open addressing’de α yükseldikçe boş slot bulmak zorlaşır; chaining’de ise
ortalama chain uzar. Belirlenen threshold aşıldığında daha büyük bir table
oluşturup bütün entry’leri yeniden yerleştirmek gerekir.
Rehashing fiziksel slot’ları yeni array’e kopyalamak değildir. M
değiştiği için her key’in index’i yeniden hesaplanmalıdır. Lab, eski ve yeni
table’ı yan yana tutarak entry’lerin neden farklı slot’lara gittiğini gösterir.
11. Hash Table Complexity Gerçekte Nedir?
Search, insert ve delete işlemleri iyi dağılım ve kontrollü load factor altında
expected O(1) olabilir. Worst-case ise bütün key’ler aynı chain’e
veya uzun probe path’ine yığıldığında O(n)’dir. Bu yüzden “hash
table daima sabit zamanda çalışır” ifadesi doğru değildir.
Average, worst-case ve amortized maliyet farklarını daha ayrıntılı incelemek için Big-O Complexity Lab rehberine geçebilirsiniz.
12. Hash Table mı Balanced BST mi?
Hash table exact-key lookup için güçlüdür, fakat key’leri sıralı tutmaz.
Minimum, maximum, predecessor, successor veya ordered traversal gerekiyorsa
balanced BST O(log n) garantisiyle daha uygun olabilir. Hash table
expected O(1) lookup verirken sağlam worst-case ve sıralama
ihtiyaçları ayrı değerlendirilmelidir.
Ağaç invariant’larını ve search path’i karşılaştırmak için Trees & BST Lab rehberimizi inceleyebilirsiniz.
13. Hash Tables Lab Nasıl Çalışılmalı?
- Aynı key set’ini farklı hash function ve table size ile dağıtın.
- İlk index’i hesaplayıp collision stratejisinin yolunu önceden tahmin edin.
- Dört stratejiyi lockstep çalıştırıp collision ve probe sayılarını kıyaslayın.
- Bir probe chain’in ortasından entry silip EMPTY ile tombstone farkını görün.
- Load factor threshold’unu değiştirerek rehashing maliyetini ölçün.
- Polito türevi challenge’larda yalnızca cevabı değil gerekçeyi yazın.
Hash Tables Lab’i açın ve key’den slot’a giden bütün kararları izleyin. Diğer uygulamalar için Academy Lab kataloğuna dönebilirsiniz.
Sonraki Adım: Bunları da Oku
Bu yazıyı tamamladıysan, bir sonraki seviyeye geçmek için şu içeriklerle devam etmeni öneririz:
Ücretsiz Seviye Analizi ile Başlayalım
Mevcut seviyenizi hızlıca analiz edip size en uygun ders planını birlikte çıkaralım.